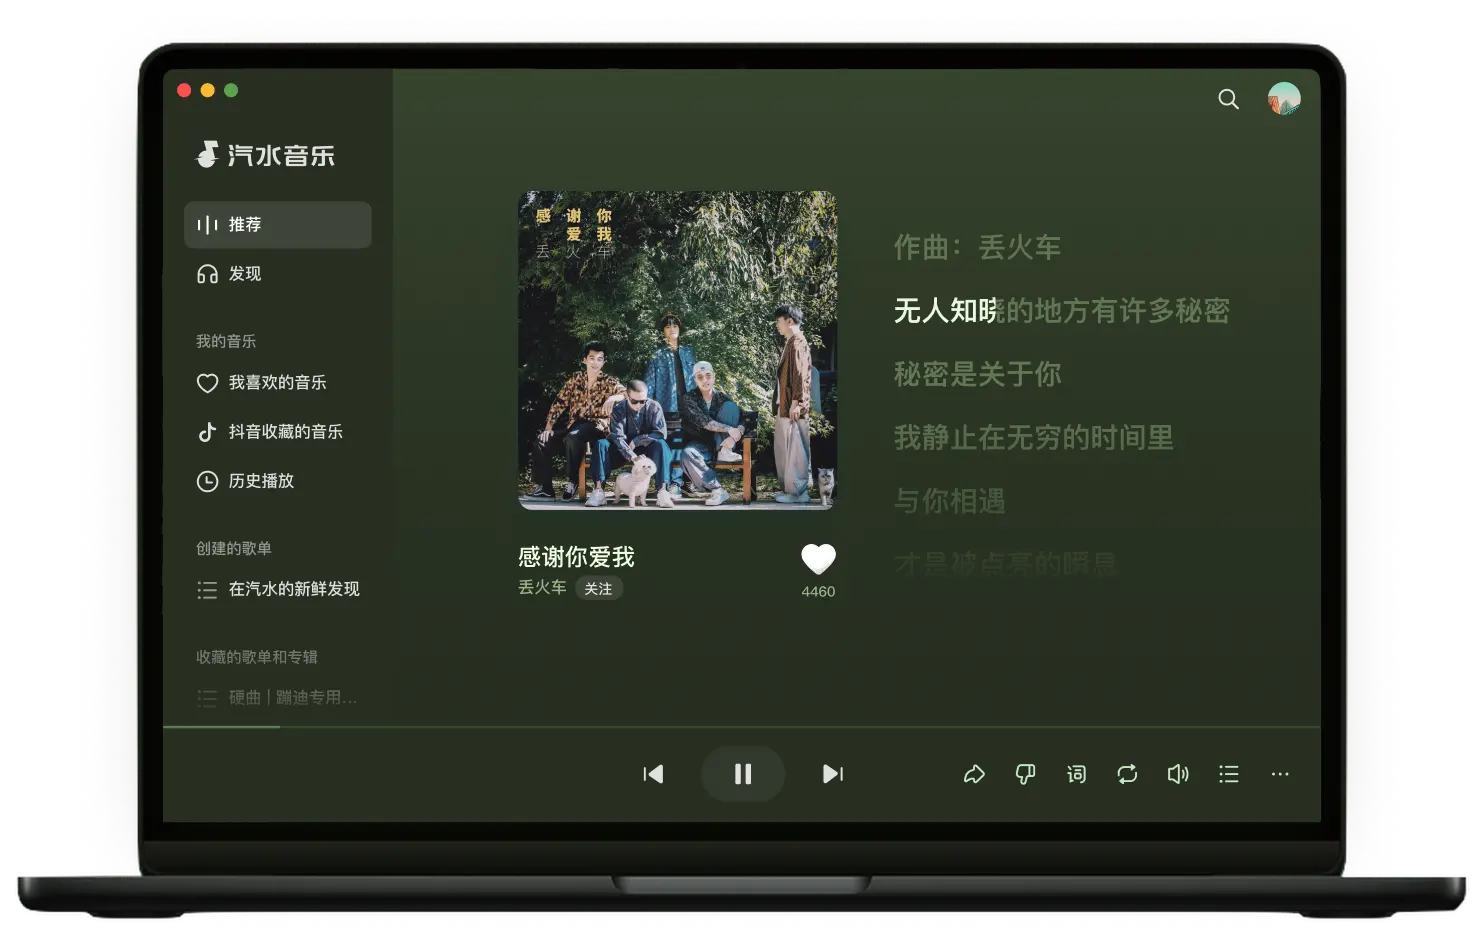
你有没有过这样的体验:打开汽水音乐,随手点开推荐流里的第一首歌,结果一连听了十几首,每首都恰到好处地落在你的审美点上。你可能会想——它怎么这么懂我?
这背后,是一套复杂但有趣的推荐系统。今天我们不谈深奥的公式,而是从产品设计的角度,聊聊汽水音乐的推荐流是如何一步步“学会”听懂你的。
一、从一次点击开始:行为埋点
推荐系统的第一步,是观察。当你使用汽水音乐时,每一个动作都在产生信号:
- 显式反馈:你点了红心、收藏了歌单、分享了歌曲——这些是明确的“喜欢”信号。
- 隐式反馈:你完整听完了一首歌、循环了三次、或者在第 15 秒就切掉了——这些行为同样在告诉系统你的偏好。
- 上下文信息:你听歌的时间(深夜还是通勤)、设备(手机还是电脑)、甚至当时的网络状态,都会作为辅助特征被记录下来。
这些数据经过清洗和结构化后,会进入一个统一的行为序列模型。它不是简单地统计“你听了多少首流行歌”,而是试图理解你听歌的顺序和节奏——比如你通常会在两首快歌之后切到一首慢歌,这种模式会被捕捉到。
推荐系统的目标不是“猜中你下一首想听什么”,而是“在你还没意识到自己想听什么之前,就把它放到你面前”。
二、兴趣向量:把你的口味变成一串数字
接下来,系统会把你的行为映射到一个高维空间里,形成一个兴趣向量。你可以把它想象成一个“音乐口味指纹”:
- 维度可能包括:节奏快慢、人声类型、编曲风格、情绪色彩、年代偏好等。
- 每个维度都有一个权重,权重会随着你的行为动态调整。
- 当你跳过一首歌时,对应维度的权重会轻微下降;当你循环播放时,权重会上升。
与此同时,每首歌也会被预先计算出一个内容向量。推荐引擎要做的,就是找到与你兴趣向量最接近的那些歌曲。
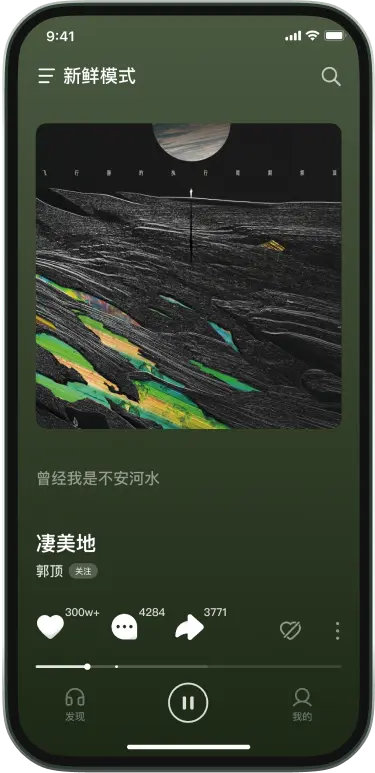
兴趣向量与歌曲向量在空间中的距离越近,推荐优先级越高
三、不只是“相似”:多样性与探索
如果推荐系统只做“相似匹配”,你很快就会陷入信息茧房——听来听去都是同一种风格。汽水音乐在推荐流中引入了两个关键机制:
1. 多样性重排
即使系统找出了 100 首与你兴趣向量高度接近的歌,也不会直接按顺序推给你。它会进行重排,确保相邻的歌曲在风格、情绪、年代上有足够的差异,避免听觉疲劳。
2. 探索与利用的平衡
推荐系统永远在“利用”(推你大概率喜欢的歌)和“探索”(推你可能喜欢但尚未发现的歌)之间寻找平衡。汽水音乐会以一定比例插入探索性推荐,这些歌可能来自你从未听过的音乐人,或者是你平时不太常听的风格。
好的推荐不是让你一直听熟悉的歌,而是让你在熟悉的舒适区边缘,不断发现新的惊喜。
四、实时反馈:推荐流是“活”的
你可能会注意到,当你在推荐流里连续跳过几首歌之后,接下来的推荐会明显发生变化。这是因为汽水音乐的推荐系统具备实时反馈能力:
- 你的每一次跳过、收藏、完整播放,都会在秒级内影响后续的推荐结果。
- 系统会维护一个短期兴趣向量和长期兴趣向量,前者捕捉你当下的心情,后者代表你稳定的口味。
- 当短期向量发生剧烈变化时,推荐流会暂时偏向短期兴趣,但不会完全抛弃长期偏好。
这种设计让推荐流既有“记忆”,又能“随机应变”。
实时反馈让推荐流能够跟上你当下心情的变化
五、那些不为人知的取舍
推荐系统的设计从来不是纯粹的数学问题,它涉及大量产品层面的取舍:
- 短期满意度 vs 长期留存:推一首你一定会喜欢的口水歌,可能让你当下很爽,但长期来看会降低你对平台的信任。
- 热门 vs 长尾:热门歌曲数据表现好,但过度推荐会让独立音乐人和小众风格失去曝光机会。
- 多样性 vs 精准度:多样性太高会让你觉得“推荐不准”,太低又会让你感到厌倦。
汽水音乐的选择是:在保证核心体验精准的前提下,尽可能为长尾和多样性留出空间。这也是为什么你偶尔会在推荐流里听到一些“不太像你平时会听”的歌——那可能是系统在试探你的边界。
结语
推荐流越来越懂你,不是因为某个神奇的算法,而是因为无数个微小的行为信号,加上一套不断迭代的反馈机制。它像一位耐心的朋友,通过每一次互动慢慢了解你的口味,同时也不忘偶尔给你带来一点新鲜感。
下次当你听到一首“刚好想听”的歌时,不妨想想背后这套系统——它可能比你想象的更努力。